

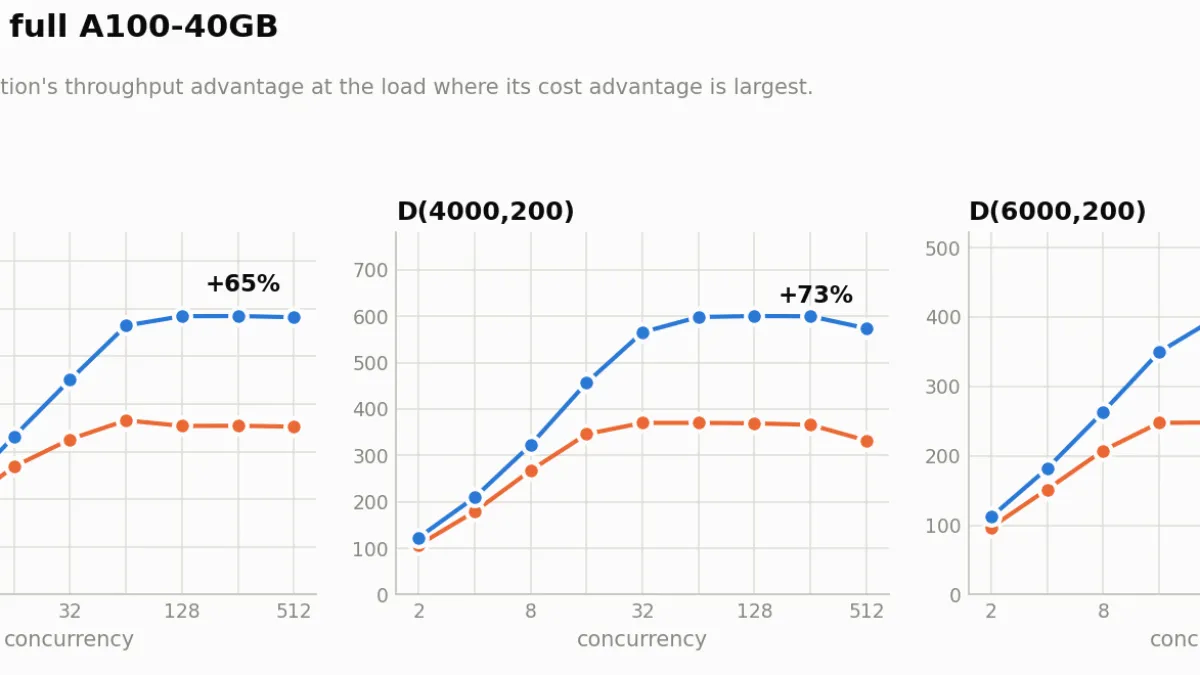
A Amazon Web Services (AWS) anunciou que o SageMaker Inference agora oferece suporte ao particionamento de placas de vídeo utilizando a tecnologia NVIDIA Multi-Instance GPU (MIG). O recurso permite dividir uma única GPU física em partições independentes com recursos isolados de processamento e memória em nível de hardware. A novidade foi validada em parceria com a Salesforce, que participou da definição dos requisitos e testes iniciais da solução.
Antes da atualização, a menor unidade computacional configurável em um endpoint de GPU era um acelerador inteiro. Com a tecnologia MIG, uma única GPU pode ser fatiada em até sete instâncias isoladas, eliminando a necessidade de dedicar uma placa inteira para modelos de pequeno ou médio porte. Essa restrição anterior forçava empresas a pagar por capacidadeciosa ou a gerenciar clusters complexos de Kubernetes por conta própria.
O particionamento de GPU no SageMaker Inference é voltado para otimizar custos e maximizar a utilização de infraestrutura em tarefas de inteligência artificial. A solução é integrada diretamente aos chamados inference components, permitindo que cada partição execute um modelo diferente com garantia de desempenho e sem risco de interferência entre processos.
Como funciona o particionamento com NVIDIA MIG
A tecnologia NVIDIA MIG divide a GPU diretamente no hardware, garantindo que cada partição receba uma fração fixa de unidades de processamento e um bloco dedicado de memória com sua própria largura de banda. Isso traz vantagens diretas em relação ao compartilhamento por software:
- Latência previsível: picos de tráfego em um modelo não afetam a latência p99 de outros modelos na mesma placa.
- Isolamento de falhas e segurança: erros de memória ou travamentos ficam restritos à partição afetada, e a proteção de memória é garantida em hardware.
- Sem “cold starts”: todos os modelos permanecem carregados em suas respectivas partições, evitando atrasos na primeira requisição.
- Previsibilidade de custos: permite associar o custo exato de cada partição a equipes, clientes ou projetos específicos.
De acordo com Richard Chang, Arquiteto de Engenharia de Software da Salesforce, a capacidade de particionar GPUs permite consolidar cargas de trabalho com segurança. “Muitas cargas de trabalho de inferência não exigem uma GPU inteira. O MIG nos permitirá consolidar cargas de trabalho com segurança, melhorar significativamente a utilização da GPU, reduzir custos de inferência e manter um desempenho previsível”, afirmou o executivo.
Limites de hardware e perfil das GPUs suportadas
O número máximo de partições varia de acordo com o modelo do acelerador e nunca excede sete por GPU física. O fatiamento depende das especificações de cada arquitetura:
- NVIDIA A100 e H100: dividem-se em até 7 partes de processamento e 8 partes de memória (ex.: perfis como mig-3g.40gb ou mig-1g.10gb).
- Família G7e: divide-se em até quatro partições.
- Família G7: permite divisão em até duas partições.
A AWS destaca que a escolha do perfil ideal deve considerar a fase de prefill (leitura de prompt, dependente de unidades de processamento) e a fase de decode (geração de tokens, dependente da largura de banda da memória e do tamanho do cache KV). Por exemplo, um modelo de 8 bilhões de parâmetros (8B) em FP16 exige cerca de 16 GB apenas para os pesos, rodando de forma confortável em uma partição de 40 GB para contextos de até 8.000 tokens.
Como aplicar o recurso nos endpoints existentes
Para utilizar o recurso, o desenvolvedor deve definir a divisão no momento da criação do endpoint. A API do SageMaker AI recebeu dois novos campos opcionais para essa finalidade:
- AcceleratorPartitionLayouts: inserido na configuração da variante de produção (CreateEndpointConfig), declara como os aceleradores da instância serão divididos de forma uniforme.
- AcceleratorPartitionType: definido no componente de inferência, especifica qual tipo de partição o modelo irá ocupar.
Durante os testes da AWS, o processo de criação e fatiamento dos aceleradores adicionou cerca de 17 segundos ao tempo total de provisionamento da instância. Vale ressaltar que o recurso requer a criação da estrutura no momento do lançamento, não sendo possível alterar o layout com partições em uso. Para instâncias P4d utilizando o perfil de menor tamanho (mig-1g.10gb), é necessário selecionar a imagem com drivers NVIDIA atualizados (linha 580) definindo a propriedade InferenceAmiVersion.
O que você precisa saber sobre o SageMaker Inference
O particionamento via MIG é indicado para quem gerencia portfólios de modelos ajustados (fine-tuning), microsserviços de IA, pipelines de várias etapas na mesma instância (como transcrição seguida de geração de texto) e modelos de segurança que rodam em todas as requisições. O recurso já está disponível na plataforma gerenciada SageMaker Inference para instâncias compatíveis, sem custos extras de API ou necessidade de gerenciar infraestrutura Kubernetes.
Fonte original: aws.amazon.com. Consulte a publicação original para contexto e atualizações.